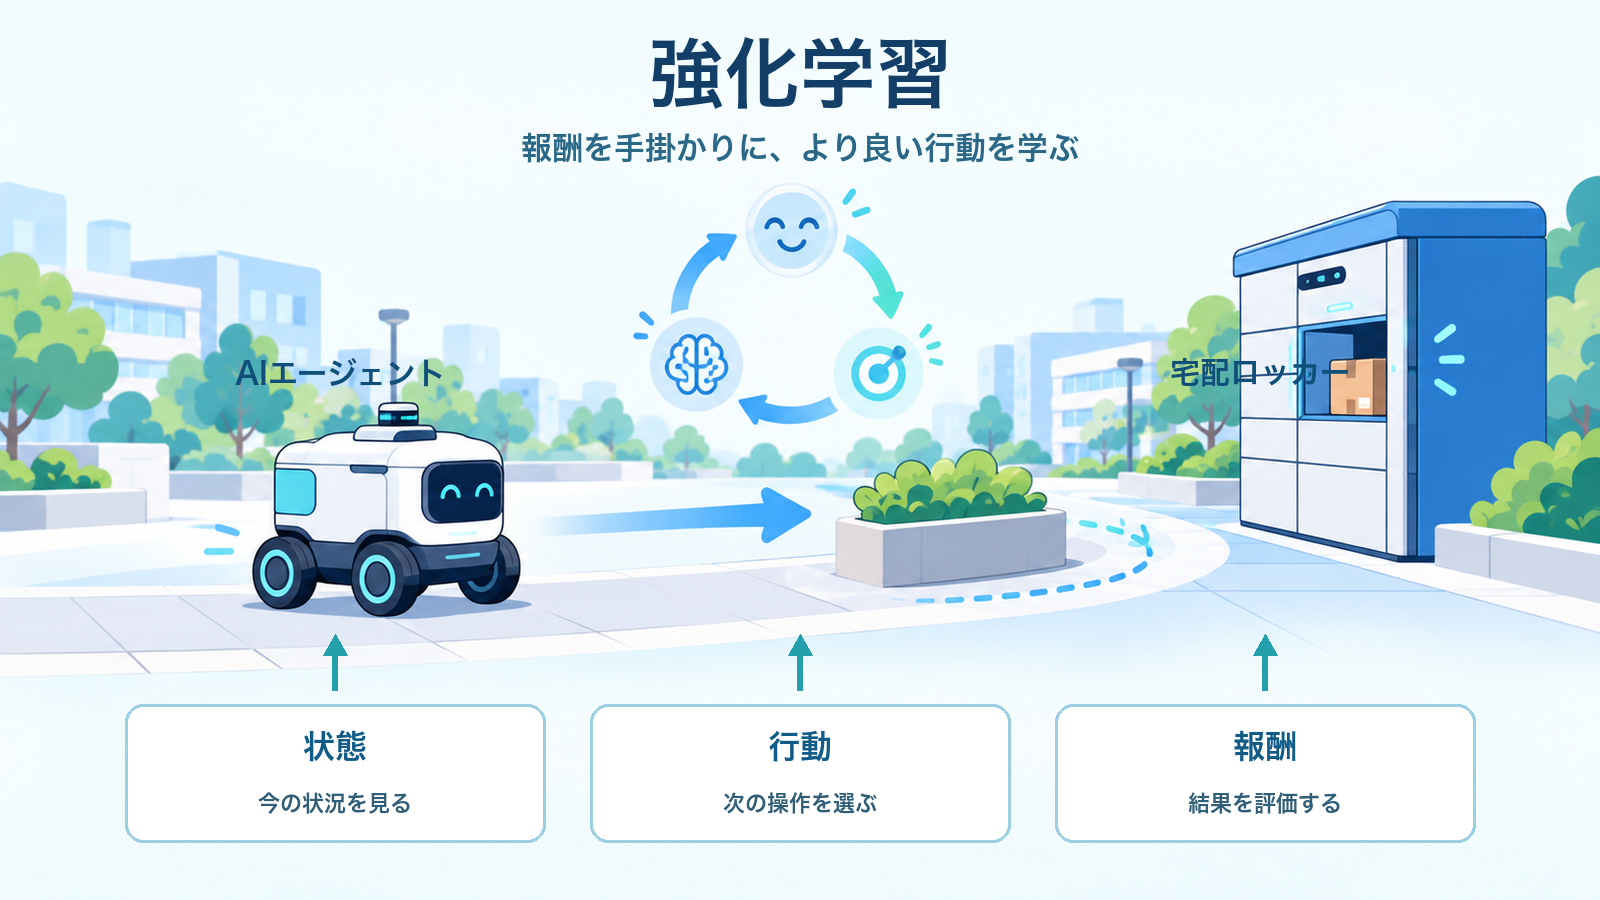
結論:強化学習は、AIが行動した結果の報酬を手掛かりに、より良い行動を選べるよう学ぶ方法です。正解を一つずつ教えるのではなく、試行錯誤を通じて方針を改善します。ITパスポートでは、教師あり学習との違いと、報酬を最大化する行動を学ぶ考え方を押さえましょう。
強化学習とは
強化学習は、AIがある環境で行動し、その結果として得る報酬を基に学習する方法です。AIは状態を観察して行動を選び、望ましい結果なら報酬を得ます。この繰り返しにより、長い目で見て得られる報酬を大きくする行動方針を探します。
教師が正解ラベルを与える学習とは異なり、強化学習では各場面で正解の行動が直接示されるとは限りません。行動の良し悪しを、結果として得られる報酬から判断する点が特徴です。IPAのITパスポート試験シラバスVer.6.5では、強化学習はAIに関する用語の一つとして扱われています。
仕組み:行動と報酬を繰り返して方針を改善する
強化学習では、学習する主体をエージェント、行動する場を環境と考えます。エージェントは環境の状態を見て行動し、環境から報酬と次の状態を受け取ります。
- 状態を観察する:現在の位置、在庫、画面上の状況など、判断に必要な情報を受け取ります。
- 行動を選ぶ:進む、止まる、順番を変えるなど、選べる行動から一つを実行します。
- 報酬を受け取る:目的に近づく結果には報酬を、望ましくない結果には低い報酬を与えます。
- 方針を更新する:将来も含めて多くの報酬を得られそうな行動を選びやすくします。
目先の報酬だけを追うと、後で不利になる行動を選ぶことがあります。そのため強化学習では、今の一回だけでなく、その後に続く結果も踏まえて方針を改善する考え方が重要です。
教師あり学習・教師なし学習との違い
| 学習方法 | 手掛かり | 主な目的 |
|---|---|---|
| 教師あり学習 | 正解付きのデータ | 入力から正解を予測する |
| 教師なし学習 | 正解のないデータ | データの特徴やまとまりを見つける |
| 強化学習 | 行動後の報酬 | 報酬を大きくする行動方針を学ぶ |
教師あり学習は、過去の正解データを使って分類や予測を行う場面に向きます。教師なし学習は、正解を用意せずに似たデータの集まりを見つける場面に向きます。これに対して強化学習は、連続する行動の結果を基に、より良い選び方を学ぶ場面に向きます。
まずAIと機械学習の基本を解説した記事で全体像を確認すると、強化学習が複数ある学習方法の一つだと整理できます。
仕事と日常生活での見方
仕事:順番や配分を決める支援
仕事では、複数の作業や資源をどの順番で配分するかが結果に影響する場面があります。強化学習の考え方では、目的を測る報酬を先に定め、選んだ順番や配分の結果を評価します。ただし、現実の業務では安全性、説明責任、例外処理なども必要です。AIの判断をそのまま実行せず、人が確認する設計が欠かせません。
生活:機器が試行結果から調整する場面
日常生活では、機器やサービスが利用状況に応じて制御を調整する仕組みを考えると理解しやすくなります。例えば、限られた電力や時間の中で快適さを保つには、今の操作だけでなく、その後の状態も考える必要があります。強化学習は、こうした連続する選択を評価する考え方と結び付きます。
AIの仕組みそのものを復習したい場合は、ニューラルネットワークの基本を読むと、AIがデータから特徴を扱う考え方を補えます。
試験で押さえる要点
- 強化学習は、行動の結果として得る報酬を手掛かりに学ぶ方法です。
- 正解ラベルを与える教師あり学習とは、学習の手掛かりが異なります。
- 目的は、一回の報酬だけでなく、将来も含めた報酬を大きくする行動方針を学ぶことです。
- 学習済みモデルを追加学習で調整する方法とは目的が異なります。ファインチューニングの解説で使い分けを確認しましょう。
確認問題
問題:AIが行動した後に得られる報酬を使い、より良い行動方針を学ぶ方法はどれですか。
- 教師あり学習
- 教師なし学習
- 強化学習
- ファインチューニング
答え:3.強化学習
解説:強化学習は、行動の結果に対する報酬を基に、より多くの報酬を得られる行動方針を学びます。教師あり学習は正解付きデータ、教師なし学習は正解のないデータを主に扱います。ファインチューニングは、学習済みモデルを特定用途へ調整する方法です。